


403
Sorry!!
Error! We're sorry, but the page you were looking for doesn't exist.
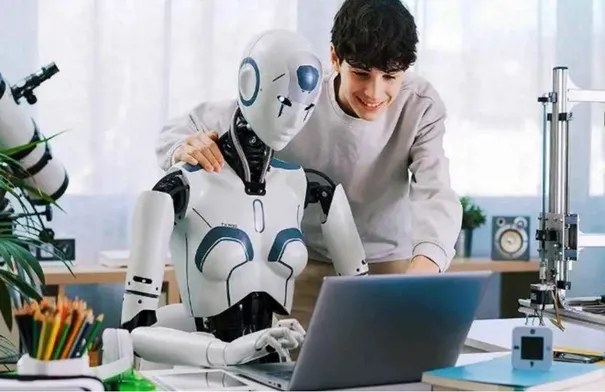
الذكاء الاصطناعي يعلّم الروبوتات أداء المهام من خلال مشاهدة الفيديوهات
(MENAFN- Al Wakeel News) الوكيل الإخباري-
يعمل باحثون وشركات تكنولوجيا على تطوير أنظمة ذكاء اصطناعي تتيح للروبوتات تعلم المهارات من خلال مشاهدة مقاطع فيديو لأشخاص يؤدون مهام يومية، بدلاً من الاعتماد على البرمجة اليدوية أو تدريبها باستخدام روبوتات حقيقية.
وتعتمد هذه التقنية على ما يُعرف بـ"التعلم بالتقليد"، إذ تحلل الأنظمة الحركات البشرية وطريقة تفاعل اليدين مع الأشياء، ثم تحولها إلى تعليمات يستطيع الروبوت تنفيذها، مثل التقاط الأكواب وفتح الأدراج واستخدام الأدوات.
ومن أبرز الأمثلة مشروع "HumanEgo"، الذي طوره باحثون في جامعة ميريلاند الأميركية عام 2026، ويتيح للروبوتات تعلم مهارات التعامل مع الأشياء من فيديوهات مصورة من منظور الشخص الأول.
ووفقاً للباحثين، تمكن النظام من اكتساب مهارات جديدة باستخدام نحو 30 دقيقة من مقاطع الفيديو لكل مهمة، محققاً متوسط نجاح بلغ 92.5% عبر أربع مهام واقعية في أحد التقييمات البحثية.
وفي يونيو/حزيران 2026، كشف باحثون في جامعة كارنيغي ميلون عن نظام "VideoManip"، الذي يحول مقاطع الفيديو البشرية إلى بيانات تدريبية، من خلال إعادة بناء حركات اليدين والأشياء بصورة ثلاثية الأبعاد، ثم ترجمتها إلى تعليمات تناسب الأيدي الروبوتية.
كما دخلت شركات التكنولوجيا هذا المجال، إذ أعلنت شركة "Figure AI" عن تقدم في نقل المهارات من الفيديو البشري إلى الروبوتات الشبيهة بالإنسان، فيما تعمل "Google DeepMind" على توظيف مقاطع الفيديو لتعليم أنظمة الذكاء الاصطناعي فهم الحركات والعالم المحيط بها.
ورغم ما يتيحه هذا التوجه من فرص لتقليل تكلفة تدريب الروبوتات وتسريع تطويرها، لا تزال هناك تحديات تتعلق باختلاف قدرات الروبوتات عن جسم الإنسان، وصعوبة تقدير القوة والاحتكاك والتوازن من الصور وحدها، فضلاً عن ضمان تنفيذ المهام بأمان.
ويأمل الباحثون أن يسهم دمج الفيديو مع المحاكاة وأجهزة الاستشعار في جعل تدريب الروبوتات أسهل وأقل تكلفة، بحيث تتمكن مستقبلاً من تعلم مهام جديدة بالمشاهدة والملاحظة والتقليد.
إخلاء المسؤولية القانونية:
تعمل شركة "شبكة الشرق الأوسط
وشمال أفريقيا للخدمات المالية" على توفير المعلومات "كما هي" دون أي
تعهدات أو ضمانات... سواء صريحة أو ضمنية.إذ أن هذا يعد إخلاء لمسؤوليتنا
من ممارسات الخصوصية أو المحتوى الخاص بالمواقع المرفقة ضمن شبكتنا بما
يشمل الصور ومقاطع الفيديو. لأية استفسارات تتعلق باستخدام وإعادة استخدام
مصدر المعلومات هذه يرجى التواصل مع مزود المقال المذكور أعلاه.
الأخبار الأكثر تداولاً
آخر الأخبار


Comments
No comment